Prometheus 架构与 TSDB 原理
Prometheus Server 将发现、采集、存储、规则和查询放在同一进程内。这种设计便于部署和排障,但也决定了单实例的内存、磁盘和查询能力存在明确上限。
1. Prometheus 整体架构
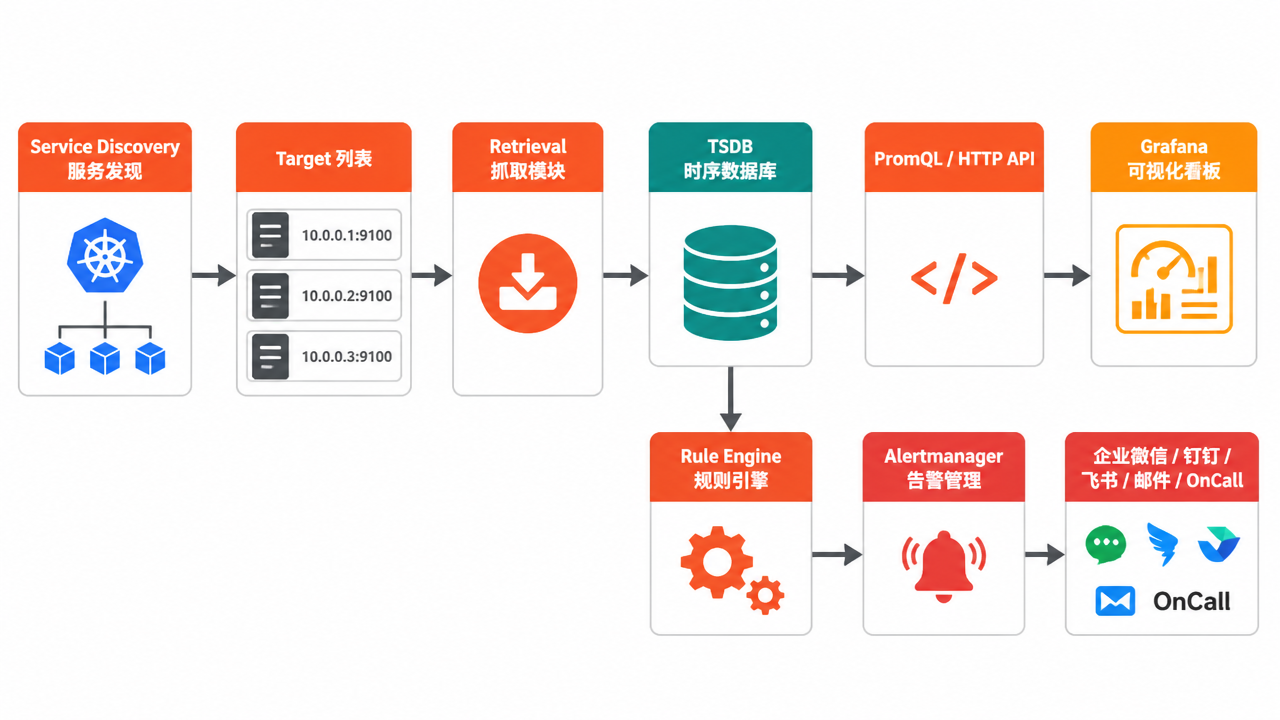
请求流程为:服务发现生成目标元数据,relabel 过滤并转换目标,抓取器请求 /metrics,样本写入 WAL 与内存 Head,规则引擎按周期查询 TSDB,查询结果可生成记录规则或告警。
2. Prometheus Server 内部结构
| 模块 | 职责 | 常见风险 |
|---|---|---|
| Retrieval | 抓取目标、处理超时和重试 | 网络、TLS、认证、抓取耗时超出超时 |
| TSDB | 存储样本、索引标签、压缩数据块 | 高基数、磁盘写满、WAL 重放慢 |
| Rule Engine | 评估记录规则与告警规则 | 查询过慢、规则维度错误、评估堆积 |
| HTTP API | PromQL、Targets、状态和管理接口 | 查询洪峰、管理端点暴露、认证缺失 |
Prometheus 自身指标是排查入口。例如 prometheus_tsdb_head_series 观察活跃序列,scrape_duration_seconds 观察抓取耗时,prometheus_engine_query_duration_seconds 观察查询成本。
3. 数据采集模型
Pull 模型
Prometheus 主动向目标发起 HTTP 请求。它能统一超时、TLS、认证和目标状态检查,并允许从 Prometheus 侧直接判断目标是否可达。大多数常驻服务和 Exporter 使用此模型。
Service Discovery
服务发现将动态基础设施转化为可抓取目标。常见来源包括 Kubernetes API、DNS、文件、Consul 和云平台。发现后的 relabel 规则决定哪些目标被保留,以及 job、instance、cluster 等标签如何生成。
Push 模型说明
短生命周期批处理任务可能在 Prometheus 下次抓取前结束。此类任务可通过 Pushgateway 暴露最近一次执行结果,或由任务输出可被抓取的状态。Pushgateway 不适合代理常驻主机:它不会自动删除失效序列,容易把旧实例误认为仍健康。
4. TSDB 存储原理
Prometheus 本地 TSDB 由 Head、WAL 和持久化 Block 组成:
- Head:最近写入的数据驻留在内存中,并持续接受新样本。
- WAL:写前日志先保证近期写入可恢复,重启后会重放。
- Block:Head 数据按时间窗口压缩为不可变块,包含样本、索引与元数据。
- Compaction:多个小块逐步合并为更大的块,减少查询与存储开销。
- Retention:按时间或容量删除过期块,先达到的限制生效。
磁盘空间不足、异常重启和高基数都会影响 WAL 与 Block。不要直接复制正在写入的 TSDB 目录作为备份;应使用存储快照或经验证的备份与恢复流程。
5. 架构边界
单机 Prometheus 适合近期指标和中小规模环境。需要跨集群查询、长期保留、多副本去重或对象存储时,应评估 Federation、Thanos、Mimir、Cortex 或 VictoriaMetrics。相关设计见 高可用与长期存储。