Kafka ZooKeeper 模式概览与运维
Apache Kafka 是高吞吐的分布式消息平台。本系列固定使用 Kafka 3.x 的 ZooKeeper 模式:ZooKeeper 负责 Broker 注册、Controller 选举和元数据协调,Kafka Broker 负责消息日志、复制和客户端读写。本文不将 KRaft 配置混入现有 ZooKeeper 集群。
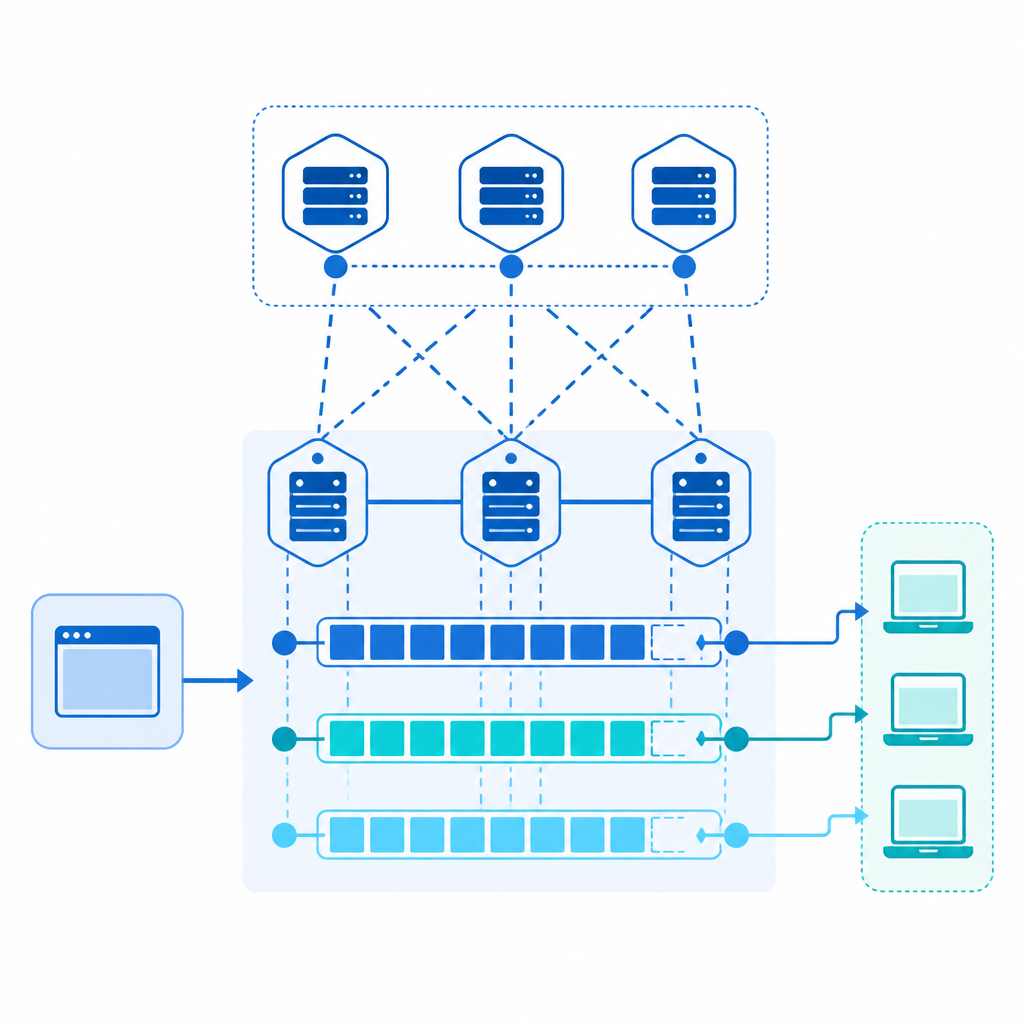
Producer --> Kafka Broker Leader --> Follower Replicas --> Consumer Group
                 |                         |
                 +--> ZooKeeper Ensemble <-+
                      元数据、注册与 Controller 选举
ZooKeeper 不是消息存储,也不应向业务客户端开放 2181。客户端仍连接 Kafka 的 9092 或 TLS/SASL 监听端口;Broker 通过 zookeeper.connect 与 ZooKeeper Ensemble 通信。
1. 运行边界
- ZooKeeper 模式仅适用于仍支持它的 Kafka 3.x 发行版;Kafka 4.x 已移除该模式。
- 不要在
server.properties中同时配置 KRaft Controller 与zookeeper.connect。 - 即使是 ZooKeeper 模式,Kafka 3.x 的 Topic、消费组等管理命令也使用
--bootstrap-server,不再使用已废弃的--zookeeper参数。 - 生产基线为 3 或 5 个奇数 ZooKeeper 节点与至少 3 个 Broker,分别使用独立持久卷和故障域。
2. 核心可靠性与性能参数(server.properties)
在生产环境中,合理的配置可以避免消息丢失并极大提高读写吞吐性能:
# 1. 基础配置
# Broker ID 在集群内唯一;替换节点时必须按迁移方案处理,不可随意复用。
broker.id=1
# 通过稳定 DNS 连接 ZooKeeper;/kafka 用于和其他 ZooKeeper 应用隔离命名空间。
zookeeper.connect=zk-1.example.internal:2181,zk-2.example.internal:2181,zk-3.example.internal:2181/kafka

# 2. 消息持久化策略 (保留 7 天,超过 100G 自动清理)
log.retention.hours=168
log.retention.bytes=107374182400
log.segment.bytes=1073741824

# 3. 性能优化 (增加网络和 I/O 线程数)
num.network.threads=8
num.io.threads=16
socket.send.buffer.bytes=102400
socket.receive.buffer.bytes=102400
socket.request.max.bytes=104857600

# 4. 可靠性与高可用配置
num.partitions=3                  # 新建 Topic 的默认分区数
default.replication.factor=3      # 默认副本因子
min.insync.replicas=2             # 最小处于同步状态的副本数(ISR)
unclean.leader.election.enable=false # 关闭不干净的选举(防止丢失消息)
3. 常用命令行运维(Kafka CLI)
提示
以下命令适用于 Kafka 3.x ZooKeeper 集群。ZooKeeper 是 Broker 的协调后端,但管理 CLI 仍须连接 Broker 的 --bootstrap-server 地址。
Topic 基础操作
# 1. 创建名为 "ops-events" 的 Topic,配置 3 分区,3 副本
kafka-topics.sh --create --if-not-exists --bootstrap-server kafka-1.example.internal:9092 --replication-factor 3 --partitions 3 --topic ops-events

# 2. 列出集群中所有的 Topic
kafka-topics.sh --list --bootstrap-server kafka-1.example.internal:9092

# 3. 查看特定 Topic 的分区与副本详细分布状态
kafka-topics.sh --describe --bootstrap-server kafka-1.example.internal:9092 --topic ops-events
生产与消费调试
# 1. 启动一个命令行生产者,往 Topic 写入测试数据
kafka-console-producer.sh --bootstrap-server kafka-1.example.internal:9092 --topic ops-events

# 2. 从头开始消费 Topic 的所有消息并输出到屏幕
kafka-console-consumer.sh --bootstrap-server kafka-1.example.internal:9092 --topic ops-events --from-beginning
消费组与积压监控
# 1. 查看集群中所有活跃的消费者组
kafka-consumer-groups.sh --bootstrap-server kafka-1.example.internal:9092 --list

# 2. 查看特定消费组的消费积压(Lag)情况(运维最常用)
kafka-consumer-groups.sh --bootstrap-server kafka-1.example.internal:9092 --describe --group ops-monitoring-group
4. 运维对象与判断原则
| 对象 | 日常观察 | 变更前确认 |
|---|---|---|
| ZooKeeper | 法定人数、Leader/Follower、会话异常和数据盘 | 不能同时下线多数节点,myid 与数据卷一一对应 |
| Broker | 磁盘水位、请求延迟、JVM、网络、Leader 数 | 没有副本不足分区,维护后有足够故障域余量 |
| Topic | 分区倾斜、保留期、副本数、ISR、消息大小 | 业务回放窗口、消费者并发和下游容量 |
| Consumer Group | Lag 增长率、重平衡、提交失败、成员数 | 回放时间点、幂等能力和下游限流策略 |
先区分“分区不可用”和“可靠性策略拒绝写入”。前者通常伴随 Offline Partition,后者常见于 ISR 小于 min.insync.replicas。不能通过降低副本数、关闭 ISR 保护或启用不清洁 Leader 选举把故障表象消除。