选择与管理工作负载
工作负载(workload)是"谁来创建和维持 Pod"的答案。除临时调试外,不应直接手工维护裸 Pod,因为它异常退出或节点失效后不会自动恢复。
本篇目标:能根据应用特性选对控制器,理解 Pod 生命周期、Init 容器、容器钩子和 QoS 等级,为后面的 Deployment/StatefulSet 等章节打基础。
1. 如何选择控制器
| 对象 | 适用问题 | 不适合什么 |
|---|---|---|
| Deployment | 无状态 API、Web、消费者 | 需要稳定编号和专属磁盘的数据库 |
| StatefulSet | 数据库、Kafka、需要固定网络身份的服务 | 每个副本完全无差别的普通 API |
| DaemonSet | 每个或指定节点运行一个 Agent | 普通应用的横向扩缩容 |
| Job | 必须完成一次的迁移、批处理、初始化 | 长期监听请求的服务 |
| CronJob | 定时备份、报表、清理 | 需要持续运行的服务 |
选择时先问四个问题:
- 它是否长期提供服务?→ 是,用 Deployment/StatefulSet/DaemonSet;否,用 Job/CronJob
- 副本是否完全可互换?→ 是,用 Deployment;否,考虑 StatefulSet
- 是否需要每个节点各运行一个?→ 是,用 DaemonSet
- 它是否完成即退出或按时触发?→ 是,用 Job/CronJob
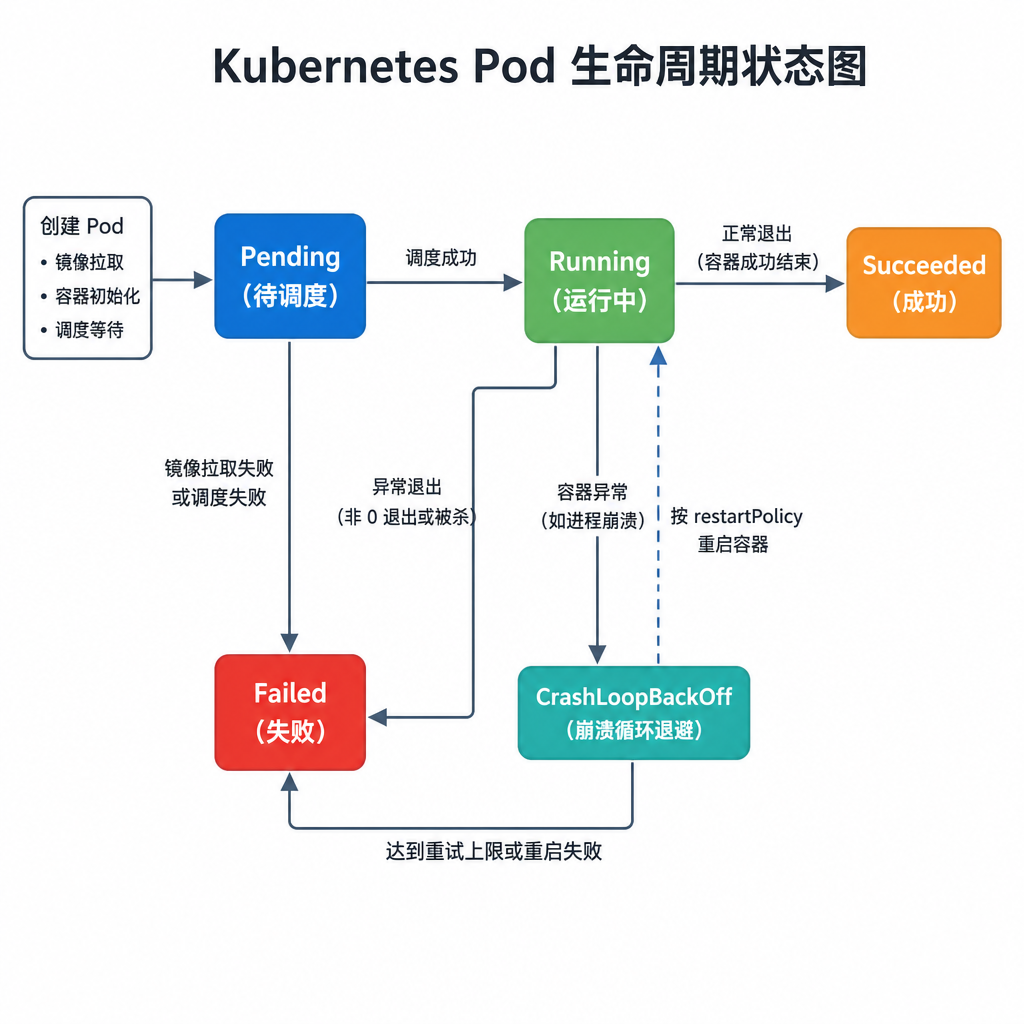
2. Pod 生命周期
2.1 状态转换
Pending ──调度成功──▶ Running ──正常退出──▶ Succeeded
  │                     │
  └── 镜像/调度失败      └── 异常退出 ──▶ Failed
                                │
                                └── 按 restartPolicy 重启 ◀── CrashLoopBackOff
| 状态 | 含义 | 排障方向 |
|---|---|---|
Pending | 已提交但尚未调度成功,或正在拉镜像 | 资源、污点、选择器、PVC、配额 |
Running | 容器已启动 | 但别轻信——进程可能在初始化,端口未必就绪 |
Succeeded | 所有容器正常退出(重启策略非 Always) | Job 完成,正常 |
Failed | 容器异常退出(重启策略非 Always) | 退出码、日志、OOM |
CrashLoopBackOff | 不断启动失败 → kubelet 延长重启间隔 | logs --previous 是最关键证据 |
Terminating | 收到删除请求,正在优雅退出 | finalizer、挂载、preStop 卡住 |
2.2 容器重启策略
Pod 的 restartPolicy 决定容器退出后的重启行为:
| 策略 | 常见控制器 | 含义 |
|---|---|---|
Always | Deployment / StatefulSet / DaemonSet | 容器退出后由 kubelet 重启 |
OnFailure | Job | 成功退出不重启,失败时重试 |
Never | Job | 容器退出后不在该 Pod 内重启 |
CrashLoopBackOff 不是独立的错误类型,而是容器不断失败、kubelet 逐步延长重启间隔(10s → 20s → 40s → … 上限 5 分钟)的结果。优先看 kubectl logs --previous,不要先删 Pod 掩盖现场。
3. Init 容器
Init 容器在主容器启动之前运行,完成后退出。典型场景是"等某个依赖就绪再启动主容器"。
spec:
  initContainers:
    - name: wait-for-db
      image: busybox:1.36
      command:
        - sh
        - -c
        - |
          until nslookup postgres.learning.svc.cluster.local; do
            echo "等待数据库 DNS 就绪…"
            sleep 2
          done
    - name: run-migration
      image: registry.example.com/app:1.4.2
      command: ["./bin/migrate"]
  containers:
    - name: api
      image: registry.example.com/app:1.4.2
Init 容器的关键特性:
- 按顺序执行,前一个成功退出才启动下一个;
- 任何一个 Init 容器失败,整个 Pod 会按
restartPolicy重试; - 可以访问与主容器不同的镜像和工具(比如拿
busybox做网络检查,主容器是精简镜像); - Init 容器完成退出后不会被重新启动(与 Sidecar 容器不同)。
4. 容器生命周期钩子
两个钩子让你在容器启动后和终止前执行自定义操作:
4.1 postStart:启动后立即执行
containers:
  - name: api
    image: registry.example.com/api:1.4.2
    lifecycle:
      postStart:
        exec:
          command: ["/bin/sh", "-c", "echo 'Container started' >> /var/log/lifecycle.log"]
postStart 和容器的 ENTRYPOINT 是异步并发运行的。如果需要严格有序(如"等配置加载完再启动进程"),用 Init 容器。
4.2 preStop:终止前优雅收尾
这是防止连接断开的关键钩子。容器收到 SIGTERM 后,kubelet 会先执行 preStop,等它完成后再发 SIGTERM 给主进程:
containers:
  - name: api
    image: registry.example.com/api:1.4.2
    lifecycle:
      preStop:
        exec:
          # 等待 5 秒让 Service 把流量切走,再退出
          command: ["/bin/sh", "-c", "sleep 5"]
# 而真正有用的做法是:应用自身在收到 SIGTERM 后依次:
# 1. 停止接收新请求(readiness 探针先标记失败)
# 2. 处理完现有请求
# 3. 关闭数据库连接
# 4. 退出进程
#
# preStop 的 sleep 是为上述步骤争取时间。配合 terminationGracePeriodSeconds 使用:
spec:
  terminationGracePeriodSeconds: 30   # 总共给 30 秒优雅退出
  containers:
    - name: api
      lifecycle:
        preStop:
          exec:
            command: ["/bin/sh", "-c", "sleep 5"]
terminationGracePeriodSeconds 是 Pod 优雅退出的总时限(默认 30 秒)。超过时限未退出,kubelet 会强制 SIGKILL。如果应用的优雅退出需要更长时间,调大这个值。
5. QoS 等级与资源框架
Pod 的 QoS 等级在生产上决定 OOM 时的存活优先级(详见第 9 章),这里先建立基本概念:
resources:
  requests:     # 调度器预留的资源
    cpu: 100m
    memory: 128Mi
  limits:       # 容器可用的上限
    cpu: 500m
    memory: 256Mi
| 规则 | 结论 |
|---|---|
| 设置了 requests 但没设 limits(或 limits > requests) | Burstable |
| requests == limits(且两者都设置了) | Guaranteed |
| 什么都没设 | BestEffort(OOM 时最先被杀) |
# 查看 Pod 的 QoS 等级
kubectl get pod <pod-name> -n learning -o jsonpath='{.status.qosClass}'
6. 一份最小工作负载清单
所有工作负载都应至少具备稳定标签、明确镜像版本和资源基线:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: web
  namespace: learning
  labels:
    app.kubernetes.io/name: web
spec:
  replicas: 2
  selector:
    matchLabels:
      app.kubernetes.io/name: web
  template:
    metadata:
      labels:
        app.kubernetes.io/name: web
    spec:
      containers:
        - name: web
          image: nginx:1.27-alpine
          ports:
            - containerPort: 80
          resources:
            requests:
              cpu: 100m
              memory: 128Mi
            limits:
              cpu: 500m
              memory: 256Mi
spec.selector.matchLabels 必须匹配 Pod 模板标签。新建时这一字段通常不可随意修改,错误的 selector 会造成控制器接管范围不清。
7. 通用操作
kubectl get deploy,sts,ds,job,cronjob -n learning
kubectl get pods -n learning -o wide
kubectl describe deployment web -n learning
kubectl get events -n learning --sort-by=.lastTimestamp

# 查看 Pod 生命周期事件(最近重启原因、OOM 等)
kubectl describe pod <pod-name> -n learning
kubectl logs <pod-name> -n learning --previous
在生产环境,清单应进入 Git,由 CI 或 GitOps 工具交付。kubectl edit 适合测试或紧急止血后的验证,不应成为长期配置来源。
8. 练习
练习 A
- 用
kubectl run创建一个裸 Pod(nginx:alpine),再delete它,感受裸 Pod 不会被自动重建 - 改用 Deployment 创建同样镜像的 Pod,
delete其中一个 Pod,观察 Deployment 是否自动补回 - 用
kubectl get pod -o jsonpath='{.status.qosClass}'查看 QoS 等级
练习 B
- 创建一个带 Init 容器的 Deployment:Init 容器打印一条消息后 sleep 3 秒,主容器用 busybox 持续 sleep
- 观察 Init 容器日志:
kubectl logs <pod-name> -c <init-container-name> - 给容器添加
preStop钩子(sleep 5),删除 Pod 后观察Terminating阶段持续时间 - 故意把
terminationGracePeriodSeconds设为 5,preStop sleep 设为 15,观察 kubelet 在 5 秒后 SIGKILL
验收清单
- 能根据应用特性选择 Deployment、StatefulSet、DaemonSet、Job 或 CronJob
- 知道 Pod 不提供稳定身份和稳定 IP
- 理解
Always、OnFailure、Never的重启边界 - 会使用 Init 容器做"启动前准备"(等依赖、跑迁移)
- 理解
preStop和terminationGracePeriodSeconds的配合 - 知道 QoS 等级(Guaranteed / Burstable / BestEffort)的判断条件
- 会检查 selector 与 Pod labels 是否匹配
下一篇:部署与更新无状态应用。