按步骤排查 Kubernetes 故障
排障先保留现场,再收集证据,最后修改。不要一看到 Pod 异常就删除或重启,它可能抹掉退出码、事件和上一次容器日志。
本篇目标:建立固定的排障路径,针对每种常见异常状态知道优先收集什么证据,并掌握网络和节点排障的实用命令。
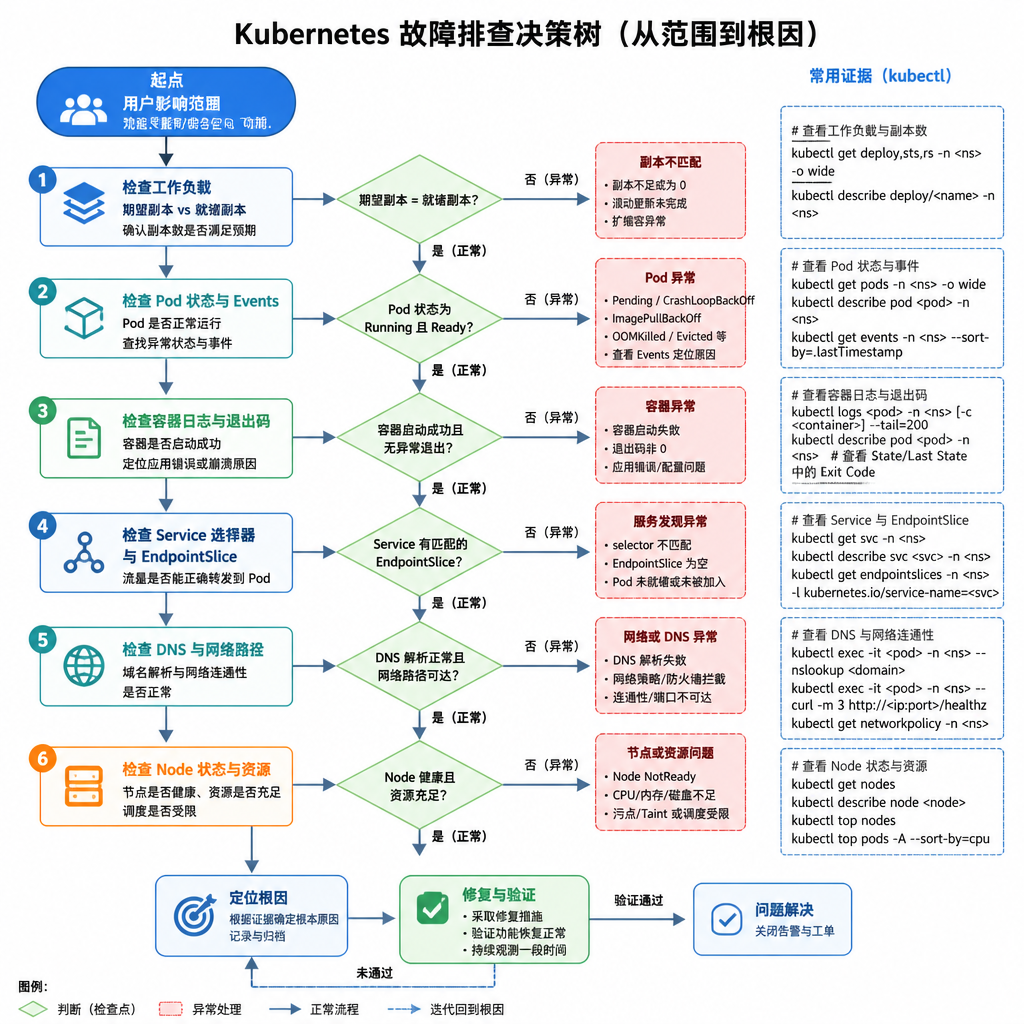
1. 固定排障路径
影响范围
  -> 工作负载期望副本是否满足
  -> Pod 状态、事件、容器日志
  -> Service / DNS / 网络路径
  -> Node、调度、存储和集群组件
  -> 修复后业务与平台双重验证
先判断是单 Pod、单服务、单 Namespace、单 Node 还是全局问题。范围越大,越应优先检查近期集群变更、节点状态、入口和 DNS,而不是单个应用 YAML。
2. 第一轮证据采集
# 看工作负载是否维持期望副本
kubectl get deployment,statefulset,daemonset -n <namespace>

# 看 Pod 位置、重启次数与状态
kubectl get pods -n <namespace> -o wide

# 看调度、拉镜像、挂载和探针事件
kubectl describe pod <pod-name> -n <namespace>
kubectl get events -n <namespace> --sort-by=.lastTimestamp

# 当前和上一次崩溃容器的日志
kubectl logs <pod-name> -n <namespace> -c <container> --tail=200
kubectl logs <pod-name> -n <namespace> -c <container> --previous --tail=200
多容器 Pod 必须明确 -c。--previous 只在容器已经重启过时有意义,是排查 CrashLoopBackOff 的关键证据。
2.1 容器退出码速查
退出码是判断崩溃原因的第一线索:
| 退出码 | 含义 | 常见原因 |
|---|---|---|
| 0 | 正常退出 | Job 完成、应用正常终止 |
| 1 | 通用错误 | 应用自身报错退出 |
| 137 | SIGKILL | 最可能是 OOMKilled(内存超 limit),或 kubelet 强制终止 |
| 139 | SIGSEGV(段错误) | 应用 bug、空指针、栈溢出 |
| 143 | SIGTERM | 正常终止信号——滚动更新、删除 Pod 时 kubelet 发送 |
# 查看上一个容器的退出码
kubectl get pod <pod-name> -n <namespace> \
  -o jsonpath='{.status.containerStatuses[*].lastState.terminated.exitCode}'
退出码 137 + Pod 事件中有 OOMKilled → 内存不足。解决方向:调大 memory limit、排查内存泄漏、或降低应用内存占用。
3. 常见状态与处理方向
| 状态 | 常见原因 | 优先证据 |
|---|---|---|
Pending | 资源不足、污点、选择器、PVC 无法绑定、配额 | Pod events、Node/PVC 状态 |
ImagePullBackOff | 镜像名、Tag、仓库权限、网络或证书 | describe 中的拉取错误、imagePullSecrets |
CrashLoopBackOff | 配置错误、启动失败、OOM、依赖不可达、探针错误 | logs --previous、退出码、探针配置 |
CreateContainerConfigError | ConfigMap/Secret/Volume 引用不存在 | Pod events 与引用对象 |
OOMKilled | 内存 limit 太低或内存泄漏 | 退出码 137、资源配置、应用内存指标 |
Terminating 很久 | finalizer、挂载、节点失联或优雅退出卡住 | describe、finalizer、节点状态 |
3.1 Pending 深度定位
kubectl describe pod <pod-name> -n <namespace> | grep -A5 Events
# 典型输出:
#   FailedScheduling: 0/3 nodes are available: 1 Insufficient cpu, 2 node(s) had taint...
Insufficient cpu/memory→ 检查 Node 资源余量kubectl top nodes,调小 request 或扩容;node(s) had taint→ 检查 Pod 是否有对应 toleration;node(s) didn't match Pod's node affinity→ 检查 nodeSelector / affinity 与 Node 标签;PVC not found或storage class not found→ 检查 PVC 和 StorageClass。
4. DNS 排障
很多"服务不通"的根因是 DNS 解析失败:
# 启动临时调试 Pod
kubectl run dns-test --image=busybox:1.36 --rm -it --restart=Never -- sh

# 在 Pod 内测试 DNS 解析
nslookup api.learning.svc.cluster.local
nslookup kubernetes.default
# 检查 CoreDNS Pod 是否 Running
kubectl get pods -n kube-system -l k8s-app=kube-dns

# 查看 CoreDNS 日志
kubectl logs -n kube-system -l k8s-app=kube-dns --tail=50

# 测试 CoreDNS 配置是否有语法错误
kubectl get configmap coredns -n kube-system -o yaml
常见 DNS 故障模式:
- CoreDNS Pod 不健康 → 所有服务间 DNS 解析失败;
- CoreDNS ConfigMap 配置错误 → 特定域名解析异常;
- Pod 的
dnsPolicy设置不当 → 部分 Pod 解析不到内部 Service; - NetworkPolicy 阻断 UDP 53 → DNS 超时。
5. Service 不通时的最短路径
# 1. Service 和它的后端
kubectl get service api -n <namespace>
kubectl get endpointslice -n <namespace> \
  -l kubernetes.io/service-name=api

# 2. 后端 Pod 的标签和状态
kubectl get pods -n <namespace> -l app.kubernetes.io/name=api

# 3. 在 Pod 内直接访问 Service
kubectl run tmp --image=busybox:1.36 --rm -it --restart=Never -- \
  wget -q -O- http://api.learning:80/healthz
按这个顺序排查:
- EndpointSlice 无地址 → selector 不匹配或 Pod 未 Ready
- EndpointSlice 正常但 wget 不通 → 容器监听端口、NetworkPolicy、CNI
- 集群内可通但外部不通 → Ingress/Gateway 规则、外部 DNS、安全组、负载均衡
不要从公网入口直接跳到"应用没启动"的结论——各层独立排查。
6. 网络调试工具
6.1 注入临时调试容器
精简镜像没有 shell 时,用 kubectl debug 注入临时容器:
# 注入一个带工具的调试容器到目标 Pod
kubectl debug <pod-name> -n <namespace> \
  --image=netshoot:latest \
  --target=<container-name> \
  -it -- sh

# 或创建调试副本(不侵入原 Pod)
kubectl debug <pod-name> -n <namespace> \
  --image=busybox:1.36 \
  --copy-to=debug-pod \
  -it -- sh
6.2 常用网络诊断命令
# 从临时 Pod 测试连通性
kubectl run tmp --image=busybox:1.36 --rm -it --restart=Never -- sh
# 进入后:
nslookup svc-name.namespace      # DNS
wget -q -O- http://svc:port/     # HTTP
nc -zv svc-name 3306             # TCP 端口
traceroute svc-name              # 路由跟踪
netshoot 镜像(nicolaka/netshoot)预装了 tcpdump、iperf、ethtool、iptables 等全套网络诊断工具,适合深度排查。
7. 节点与集群问题
kubectl get nodes -o wide
kubectl describe node <node-name>
kubectl get pods -A --field-selector spec.nodeName=<node-name>
7.1 节点状态与条件
关注 kubectl describe node 中的 Conditions 字段:
| 条件 | 含义 | 处理 |
|---|---|---|
Ready: False | 节点不可用 | 检查 kubelet、容器运行时、网络 |
MemoryPressure: True | 内存不足,开始驱逐 Pod | 扩容或降低内存使用 |
DiskPressure: True | 磁盘不足,可能触发镜像/容器 GC | 清理磁盘、扩容 |
PIDPressure: True | 进程数接近上限 | 检查是否有进程泄漏 |
NetworkUnavailable: True | CNI 网络未就绪 | 检查 CNI 插件状态 |
节点问题可能同时影响多个无关应用。先停止在该节点继续发布或调度新工作负载(cordon),再按平台运行手册处置。
8. 调试工具的边界
kubectl exec适合镜像内已有诊断工具的场景(如bash、curl);- 精简镜像用
kubectl debug注入临时容器,但它可能需要较高权限,也可能接触生产数据和网络——使用受控镜像、最小权限和变更留痕; - 导出日志和事件到本地做离线分析,减少对生产集群的操作频次。
9. 练习
练习 A
- 创建一个 Deployment,镜像用不存在的 tag(如
nginx:999.999),观察 Pod 进入ImagePullBackOff - 用
kubectl describe pod和kubectl get events定位原因 - 创建第二个 Deployment,容器命令为
sleep 5 && exit 1,观察CrashLoopBackOff,用logs --previous取证
练习 B
- 用
busybox启动一个临时 Pod,分别用nslookup、wget测试集群内部 Service 的连通性 - 创建一个 Service selector 故意与 Pod labels 不匹配的情况,用
get endpointslice验证无后端 - 修复 selector,观察 EndpointSlice 出现地址
验收清单
- 遇到故障先界定影响范围,再收集事件和日志
- 会针对 Pending、镜像拉取、崩溃和 OOM 选择正确证据
- 会解读退出码(0/1/137/139/143)快速锁定方向
- 会使用临时 busybox Pod 做 DNS 和 HTTP 连通性测试
- 知道
kubectl debug用于精简镜像的调试 - 会先查 EndpointSlice 再查 Ingress/外部网络
- 知道节点异常会同时影响多个服务
下一篇:升级与维护集群。