自动扩缩容与可用性
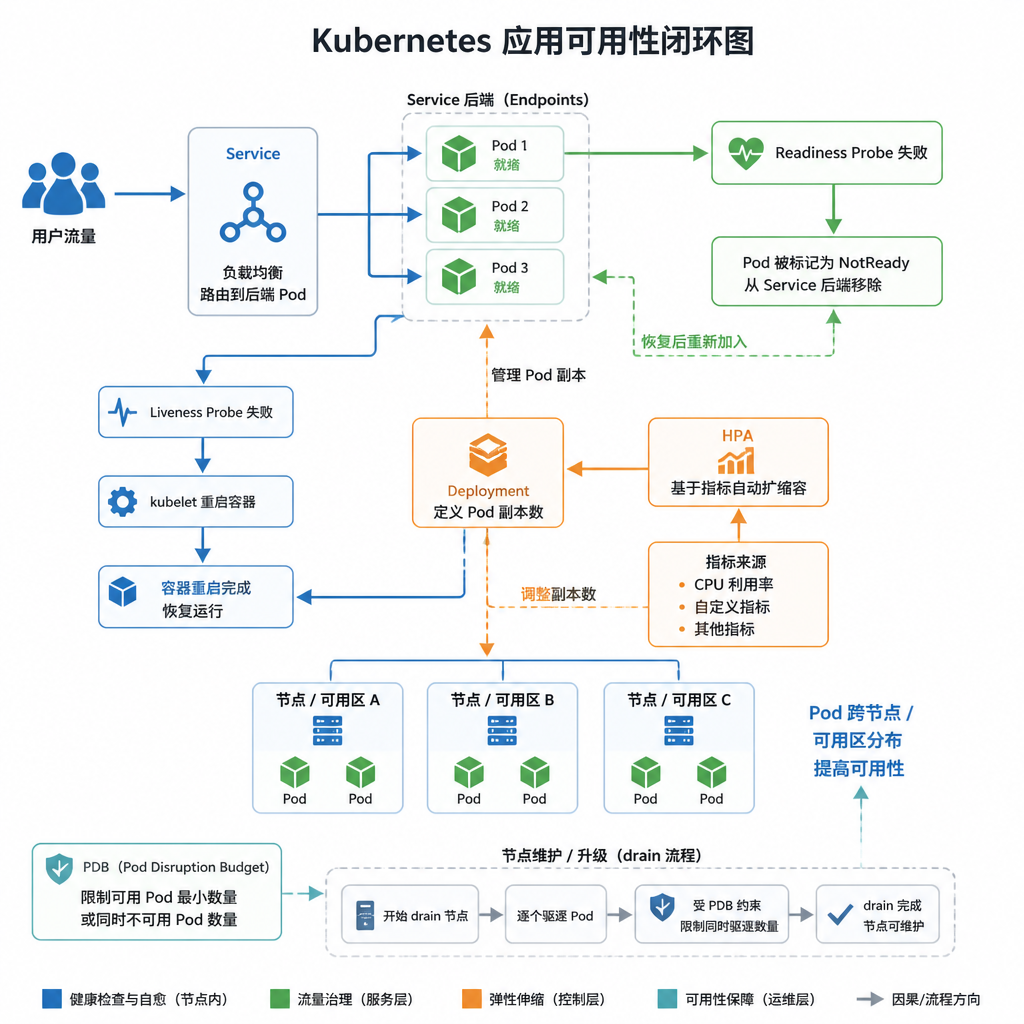
可用性不是简单把 replicas 调大。应用必须有可调度的资源请求、可工作的就绪探针、合理的副本分布,并在节点维护时允许安全驱逐。
本篇目标:能独立配置 requests/limits、三种探针、HPA 和 PDB,并理解 Pod 分布策略如何影响可用区级容灾。
1. Requests 与 Limits
resources:
  requests:
    cpu: 100m
    memory: 128Mi
  limits:
    cpu: 500m
    memory: 256Mi
| 概念 | 作用 | 超出后果 |
|---|---|---|
| request | 调度器为 Pod 预留资源的依据;也决定 QoS 等级 | 无 request → 调度结果不可预测,容量规划失效 |
| CPU limit | 容器可使用的 CPU 上限 | 超出时被节流(throttle),应用变慢但不被杀 |
| memory limit | 容器可使用的内存上限 | 超出时容器被 OOMKilled,Pod 重启 |
资源值应来自压测和监控数据。给太低——Pod 可能被调度到已经过载的节点上;给太高——节点碎片化、大量资源闲置。至少让 request 等于应用在正常负载下的平均用量,limit 给峰值留 20%-50% 余量。
1.1 QoS 等级
Kubernetes 根据 requests 和 limits 的配置方式为 Pod 分配 QoS 等级,OOM 时按优先级杀 Pod:
| QoS 等级 | 条件 | OOM 优先级 |
|---|---|---|
| Guaranteed | 每个容器的 CPU 和内存 request == limit(且都设置了) | 最后被杀 |
| Burstable | 至少一个容器设置了 request,但不满足 Guaranteed 条件 | 中等 |
| BestEffort | 没有任何容器设置 request 或 limit | 最先被杀 |
生产关键服务至少应是 Burstable,核心服务建议 Guaranteed。
2. 三种探针
探针是 kubelet 判断容器是否健康的手段。Pod Running 只说明进程已启动,不代表能正常处理请求。
2.1 三种探针的分工
| 探针 | 作用 | 失败后果 | 典型使用 |
|---|---|---|---|
| startup | 判断容器是否已启动完成 | 阻塞 readiness 和 liveness,直到首次成功 | 启动慢的应用(Java、数据库) |
| readiness | 判断容器是否可以接流量 | 从 Service 后端移除,不重启容器 | 所有接收请求的服务 |
| liveness | 判断容器是否还"活着" | 重启容器 | 死锁、无响应的场景 |
liveness 的目标是"应用卡死,重启是唯一恢复方式"。不要把"暂时慢了"当作"卡死"——failureThreshold 太小或 periodSeconds 太短,正常负载波动也可能触发误杀。生产上 readiness 是必须的,liveness 只在确认需要时才加。
2.2 探针配置示例
containers:
  - name: api
    image: registry.example.com/api:1.4.2
    ports:
      - containerPort: 8080
    # 启动探针:给 Java 应用足够启动时间
    startupProbe:
      httpGet:
        path: /healthz
        port: 8080
      initialDelaySeconds: 0
      periodSeconds: 5
      failureThreshold: 30     # 最多等 30×5=150 秒启动
    # 就绪探针:决定是否接入 Service 后端
    readinessProbe:
      httpGet:
        path: /ready
        port: 8080
      periodSeconds: 10
      failureThreshold: 3      # 连续失败 3 次才标记 NotReady
      successThreshold: 1
    # 存活探针:仅在确认需要重启时配置
    livenessProbe:
      httpGet:
        path: /healthz
        port: 8080
      periodSeconds: 30
      failureThreshold: 5      # 连续失败 5 次(150 秒)才重启
2.3 探针参数速查
| 参数 | 含义 | 建议 |
|---|---|---|
initialDelaySeconds | 容器启动后等多久开始探测 | startup probe 设为 0,其他按需 |
periodSeconds | 探测间隔 | readiness 5-10s,liveness 20-30s |
timeoutSeconds | 单次探测超时 | 通常 1-3s |
failureThreshold | 连续失败多少次判定为失败 | readiness 2-3,liveness 3-5 |
successThreshold | 连续成功多少次判定为成功 | readiness 1-2 |
3. HPA:按指标调整副本
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: api
  namespace: learning
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: api
  minReplicas: 2
  maxReplicas: 10
  metrics:
    - type: Resource
      resource:
        name: cpu
        target:
          type: Utilization
          averageUtilization: 70
3.1 扩缩行为控制
默认的 HPA 扩缩容可能过于激进——短暂 CPU 尖峰就扩容,负载回落就立即缩容,造成"抖动"。用 behavior 控制节奏:
spec:
  behavior:
    scaleDown:
      # 缩容前等待 5 分钟,确认负载确实持续低位
      stabilizationWindowSeconds: 300
      policies:
        - type: Percent
          value: 10        # 每次最多缩掉当前副本数的 10%
          periodSeconds: 60
    scaleUp:
      # 扩容无需等待窗口,快速响应
      stabilizationWindowSeconds: 0
      policies:
        - type: Percent
          value: 100       # 每次最多翻倍
          periodSeconds: 15
        - type: Pods
          value: 4         # 或每次最多加 4 个 Pod
          periodSeconds: 15
      selectPolicy: Max    # 取两个策略中的较大值
3.2 HPA 的前提条件
- Metrics Server 必须已部署(CPU/内存 HPA 依赖它),验证:
kubectl top pods -A有数据输出即正常; - HPA 只改副本数,节点容量不足时 Pod 仍然 Pending——需配合 Cluster Autoscaler 或容量预留;
- 业务指标 HPA(如 QPS、延迟)需要自定义 Metrics Adapter(Prometheus Adapter 等);
- Deployment 必须设置了
resources.requests,否则averageUtilization无法计算百分比。
4. PDB:节点维护时保留最小可用副本
apiVersion: policy/v1
kind: PodDisruptionBudget
metadata:
  name: api
  namespace: learning
spec:
  minAvailable: 2
  selector:
    matchLabels:
      app.kubernetes.io/name: api
PDB 约束的是 drain、集群升级等自愿中断,不能阻止节点宕机、OOM 或应用自身崩溃。
# 驱逐前先检查 PDB 是否会阻塞操作
kubectl get poddisruptionbudget -A
| 场景 | PDB 行为 |
|---|---|
| 满足 PDB 条件 | drain 正常驱逐 Pod |
不满足 PDB(如单副本 minAvailable: 1) | drain 一直等待,永不完成 |
| 节点突然宕机 | PDB 不干预——这是非自愿中断 |
单副本 Deployment 配置 minAvailable: 1 会导致节点 drain 永远无法完成——因为没有任何 Pod 可以安全驱逐。维护前应先扩容到至少 2 副本,或临时删除 PDB。
5. Pod 分布策略
即使有 3 个副本,如果调度到同一节点或同一可用区,一次宕机就能让服务不可用。
5.1 Pod Anti-Affinity(分散副本)
spec:
  template:
    spec:
      affinity:
        podAntiAffinity:
          # 硬约束:同一 hostname 上不能有两个 api Pod
          requiredDuringSchedulingIgnoredDuringExecution:
            - labelSelector:
                matchLabels:
                  app.kubernetes.io/name: api
              topologyKey: kubernetes.io/hostname
requiredDuringScheduling 是硬约束,副本数超过可用节点数时多余的 Pod 会 Pending;改为 preferredDuringScheduling 则是软偏好,不阻塞调度。
5.2 Topology Spread Constraints(跨可用区均匀分布)
spec:
  template:
    spec:
      topologySpreadConstraints:
        - labelSelector:
            matchLabels:
              app.kubernetes.io/name: api
          # 在可用区维度上,任意两个 zone 的 Pod 数量差不超过 1
          maxSkew: 1
          topologyKey: topology.kubernetes.io/zone
          whenUnsatisfiable: ScheduleAnyway  # 做不到也不阻塞
比 anti-affinity 更精确——它保证的是"均匀分布",而不是简单的"不在一起"。推荐同时使用 podAntiAffinity(节点级)和 topologySpreadConstraints(可用区级)。
6. 基础可用性清单
- 至少两个副本,且
readinessProbe成功才进入 Service 后端; startupProbe覆盖冷启动慢的场景,livenessProbe只在确认需要时配置;- 使用 Pod anti-affinity 或 Topology Spread Constraints 分散到不同节点和可用区;
- 资源 requests/limits 来自压测数据,关键服务使用 Guaranteed QoS;
- HPA 设置合理的 min/max 和 stabilization 窗口,避免抖动;
- 为关键服务设置 PDB,单副本服务维护前先扩容;
- 告警覆盖:副本不足、Pending Pod、节点资源压力。
7. 练习
练习 A
- 为一个 Deployment 添加
readinessProbe(httpGet),用kubectl describe pod确认探针生效 - 故意让就绪探针端点返回 500,观察 Pod 从 Service EndpointSlice 中移除
- 修复端点后观察 Pod 重新加入后端
练习 B
- 创建一个 HPA(CPU 70%,min=2,max=5),用
kubectl describe hpa观察当前指标 - 给同一 Deployment 创建 PDB(
minAvailable: 1) - 模拟节点维护:
kubectl drain <node> --ignore-daemonsets --dry-run=client,观察是否有驱逐阻塞提示
验收清单
- 能解释 request、limit、CPU 节流和 OOMKilled
- 会区分 readiness、liveness、startup 三种探针的用途和失败后果
- 知道 HPA 需要 Metrics Server 且不提供节点容量
- 会配置 HPA 的扩缩行为(stabilizationWindow、policies)
- 知道 PDB 只处理自愿中断,单副本 + PDB 会阻塞维护
- 能用 anti-affinity 和 topologySpreadConstraints 分散副本
下一篇:让应用对外提供服务。