日常巡检与发布
生产运维的目标不是频繁执行 kubectl,而是让每次变更可审阅、每次异常有证据、每个资源有负责人。日常操作应优先使用 Git 声明和交付流水线,kubectl 用于观察、诊断和紧急止血。
本篇目标:建立分级巡检节奏、可复用的发布检查表,理解 GitOps 的协作边界,以及变更留痕的基本要素。
1. 分级巡检
每天只跑一套命令是不够的——有些信号需要每天关注,有些适合每周复盘。
1.1 每日巡检(5 分钟)
目标:判断集群和工作负载"现在有没有问题"。
# 节点是否都 Ready
kubectl get nodes

# 是否有非 Running 的 Pod(排除已正常完成或 Evicted 的)
kubectl get pods -A --field-selector=status.phase!=Running \
  | grep -v -E 'Completed|Succeeded|Evicted'

# 工作负载是否维持期望副本
kubectl get deployment,statefulset,daemonset -A

# 最近 30 分钟的 Warning 事件
kubectl get events -A --field-selector type=Warning \
  --sort-by=.lastTimestamp | tail -20

# 节点资源水位
kubectl top nodes
kubectl top pods -A --containers --sort-by=cpu | tail -20
1.2 每周检查(15 分钟)
目标:发现慢性的、累积性的问题。
- 资源趋势:对比本周与上周的 CPU/内存峰值,判断是否需要调整 requests/limits;
- PVC 容量风险:通过 CSI / 存储监控指标,或在挂载卷的 Pod 内执行
df检查实际使用率;kubectl get pvc -A只用于确认 PVC 状态和申请容量; - 证书到期:检查 Ingress TLS 证书、内部 CA 证书的有效期(距离到期少于 30 天应告警);
- 备份验证:确认本周定时备份任务全部成功,至少恢复演练一次;
- HPA 行为:检查 HPA 是否频繁扩缩("抖动"),
kubectl describe hpa看最近事件。
1.3 月度检查(30 分钟)
目标:安全与合规审计、容量规划。
- RBAC 审计:列出所有
cluster-admin和写权限的 RoleBinding,确认权限授予符合预期; - 废弃 API 检测:用
kubent或pluto扫描集群中使用的废弃 API 版本(为升级做准备); - 未使用资源:检查无主 PVC、未关联 Service 的 Deployment、过期 Job/CronJob;
- 容量规划:汇总未来 3 个月的节点扩容需求;
- 准入策略:确认准入控制器规则仍在正确执行,无绕过记录。
这些命令只提供快照。应配合 Prometheus 告警跟踪,避免人工轮询成为唯一监控方式。
2. 监控与告警推荐
以下 8 个指标覆盖了最常见的集群和应用故障模式。如果监控体系还没建立,从这 8 个开始。
| # | 告警指标 | 为什么重要 |
|---|---|---|
| 1 | Pod 重启率 > 阈值(如 1 次/小时) | CrashLoopBackOff 的前兆,比 "Pod 挂了" 更早发现 |
| 2 | Pending Pod 超过 5 分钟 | 资源不足、调度失败、PVC 无法绑定的信号 |
| 3 | Deployment / StatefulSet 副本不满足 | 服务降级的直接证据 |
| 4 | 节点 NotReady | 影响面最大,优先响应 |
| 5 | 节点磁盘使用率 > 85% | DiskPressure 会触发 Pod 驱逐 |
| 6 | API Server 错误率或延迟 | 控制面异常,可能影响所有变更操作 |
| 7 | HPA 频繁扩缩(1 小时内 > 5 次) | 指标配置不合理或业务异常,需人工介入 |
| 8 | Ingress / Gateway 5xx 错误率 | 用户可见的故障信号 |
Pod 重启率 → Prometheus: rate(kube_pod_container_status_restarts_total[1h])
节点磁盘  → Prometheus: node_filesystem_avail_bytes / node_filesystem_size_bytes
就绪副本  → Prometheus: kube_deployment_status_replicas_ready / kube_deployment_spec_replicas
3. 发布流程
3.1 发布前检查表
在 PR 合并和发布执行前,逐项确认:
- 清单来自 Git,镜像版本可追踪(不使用
latest),变更有 PR 和至少一人评审 - Namespace、labels、Service selector 与现有资源无冲突
- 资源 requests/limits 已设置且来自压测数据
- readiness / liveness / startup probe 已配置且参数合理
- 数据库迁移已评审,确认向前/向后兼容性(回滚不丢数据或不阻塞旧版本)
- 配置变更(ConfigMap/Secret)已评估是否需要滚动重启
- HPA min/max 和 PDB 配置与本次发布兼容
- 在测试环境已跑过
kubectl diff -f <manifest>,确认实际变更范围 - 明确发布责任人、观察窗口(> 15 分钟)和失败回滚步骤
3.2 发布后验证
# 等待滚动更新完成
kubectl rollout status deployment/api -n production --timeout=5m

# 确认新 Pod 进入 Ready,旧 Pod 已终止
kubectl get pods -n production -l app.kubernetes.io/name=api -o wide

# 确认 Service 后端已更新为新 Pod
kubectl get endpointslice -n production -l kubernetes.io/service-name=api

# 查看新 Pod 日志,排除启动错误
kubectl logs deployment/api -n production --tail=100
# 验证历史版本已保留(以备回滚)
kubectl rollout history deployment/api -n production
除了 Kubernetes 资源状态,必须同时验证业务指标:
- 业务成功率(如 API 200 比例)是否与发布前持平?
- P99 延迟是否上升?
- 队列堆积是否增加?
- 关键依赖(数据库、缓存、消息队列)连接是否正常?
- 用户关键路径(登录、下单、支付等)是否可用?
Pod Running 不是发布成功的充分条件。业务指标正常才是。
3.3 回滚路径
# 回滚到上一个可用 Revision
kubectl rollout undo deployment/api -n production

# 回滚到指定版本
kubectl rollout undo deployment/api -n production --to-revision=3

# 确认回滚完成
kubectl rollout status deployment/api -n production --timeout=5m
回滚只回滚 Deployment 的 Pod 模板(镜像版本、环境变量、资源等),不能自动回滚:
- 数据库迁移(DDL、数据变更)——需要独立的迁移回滚方案;
- 外部 API 副作用(已发送的通知、已创建的工单);
- 已删除或修改的 ConfigMap/Secret 数据。
涉及兼容性变更时,应先设计向前兼容的发布方案——新版本能处理旧数据,旧版本能容忍新字段。
4. GitOps 协作边界
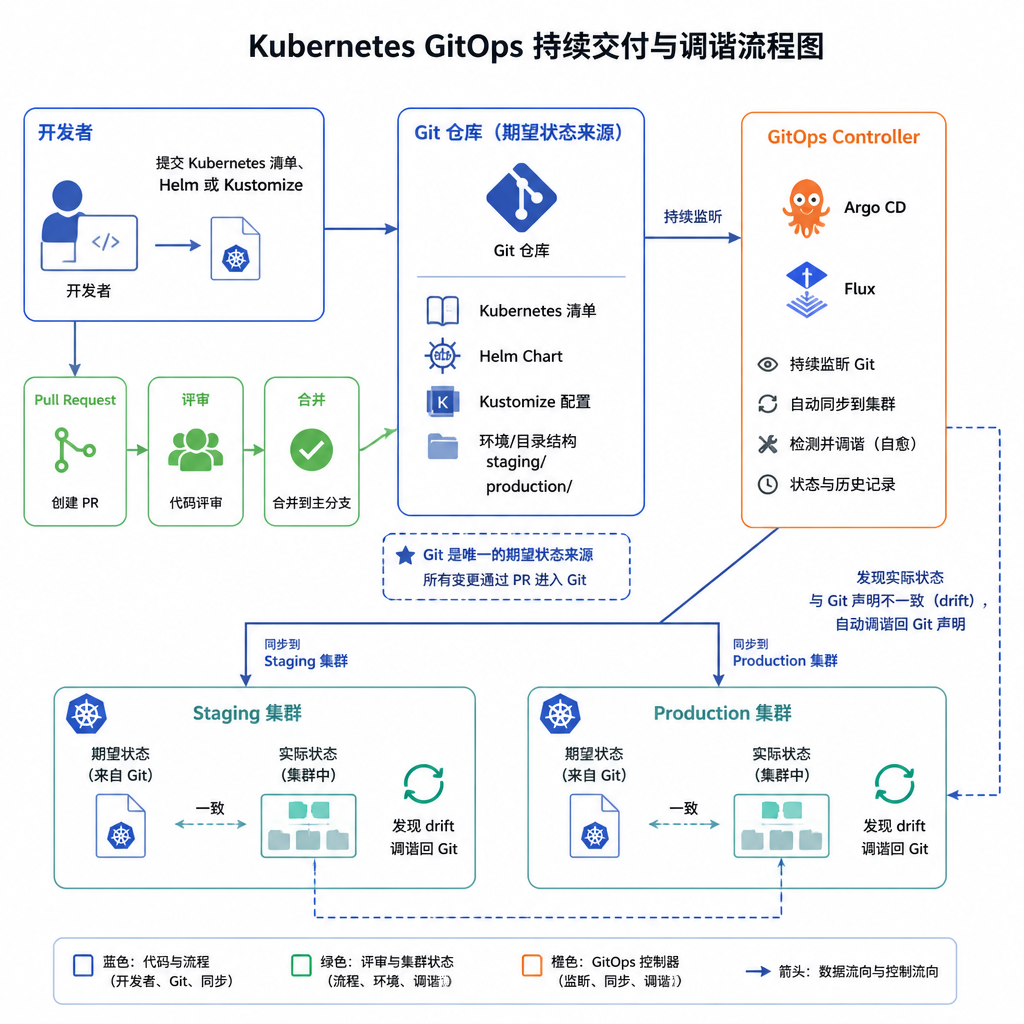
GitOps 工具(如 Argo CD、Flux)应是目标环境的期望状态来源。它不是"自动化部署工具",而是持续调谐 Git 声明与实际状态的控制器。
开发者 ──PR──▶ Git 仓库(清单 / Helm / Kustomize)
                    │
                    ▼
              Argo CD / Flux(持续 watch)
                    │
           ┌────────┴────────┐
           ▼                 ▼
      Staging 集群       Production 集群
协作纪律:
| 场景 | 做法 |
|---|---|
| 日常变更 | 修改 Git → PR 评审 → 合并 → GitOps 工具自动同步 |
| 紧急止血 | kubectl 直接操作 → 必须在 15 分钟内把同等变更回写 Git |
| 调试排查 | kubectl 只读操作(get、describe、logs、top)不受限制 |
| 手动 apply 后 | 如果 Argo CD 检测到 drift,会尝试覆盖你的手工修改——所以必须把变更落地到 Git |
紧急情况下手工 kubectl scale 或 kubectl set image 之后,Argo CD 可能会在几分钟内把你的修改"修正"回 Git 中声明的状态。止血后第一件事:把同等变更提交 PR 并合并,让 Git 成为新的真实来源。
- 为平台组件、应用和环境设置清晰的仓库与权限边界(如
platform/infra、teams/order-system); - 禁止手工
kubectl apply覆盖 GitOps 管理的对象; - Secrets 不存 Git 明文,通过 External Secrets / Vault 在集群侧注入。
5. 变更留痕
每项生产变更至少记录以下信息。故障场景再附上事件、日志和指标链接,方便后续复盘。
## 变更记录 · 2026-07-31

| 项目 | 内容 |
| --- | --- |
| **变更标题** | 将 API 镜像升级到 v1.5.2 |
| **影响范围** | `production/api` Deployment,影响用户登录和查询接口 |
| **变更类型** | 镜像版本升级 |
| **版本信息** | registry.example.com/api:1.5.2(Git SHA: a1b2c3d) |
| **预计风险** | 低——仅变更镜像标签,rollout 期间 maxUnavailable=1 |
| **开始时间** | 2026-07-31 02:00 UTC |
| **结束时间** | 2026-07-31 02:03 UTC |
| **验证结果** | ① rollout status 通过;② 业务成功率 99.8%(持平);③ P99 延迟 120ms → 115ms(略降) |
| **回滚路径** | `kubectl rollout undo deployment/api -n production --to-revision=5` |
| **实际回滚** | 无需回滚 |
| **操作人** | platform-team |
6. 练习
练习 A
- 在你的练习集群中跑一遍每日巡检脚本,输出所有节点状态和异常 Pod
- 检查是否有
FailedScheduling或ImagePullBackOff类型的 Warning 事件 - 创建一个 Deployment(2 副本),模拟一次发布:修改镜像 tag →
kubectl apply→rollout status→rollout history - 尝试回滚到上一个版本
练习 B
- 在一个 Deployment 上创建 HPA(CPU 80%),用
kubectl describe hpa观察扩缩容事件 - 创建 PDB,设置
minAvailable: 1,尝试kubectl drain一个节点,观察驱逐是否被 PDB 阻塞 - 按第 5 节模板,为你的"发布"练习写一份变更记录
验收清单
- 有每日集群与工作负载健康检查
- 有分级检查意识(每日/每周/月度各有侧重点)
- 知道至少 5 个应该配置告警的关键指标
- 知道资源健康和业务健康需分别验证
- 生产发布走 Git 审阅与流水线,不长期依赖手工 apply
- 紧急修改后会立即回写声明式配置并留存记录
- 变更留痕包含影响范围、版本、验证结果和回滚路径
下一篇:按步骤排查故障。