升级与维护集群
集群生命周期操作会影响多个 Namespace 和工作负载。节点维护、Kubernetes 版本升级、CNI/CSI 升级和证书轮换都应按变更计划执行,不能把命令成功当作业务恢复。
本篇目标:能安全执行节点 cordon/drain/uncordon,理解版本升级的顺序和风险,掌握 etcd 备份恢复的基本操作和废弃 API 的检测方法。
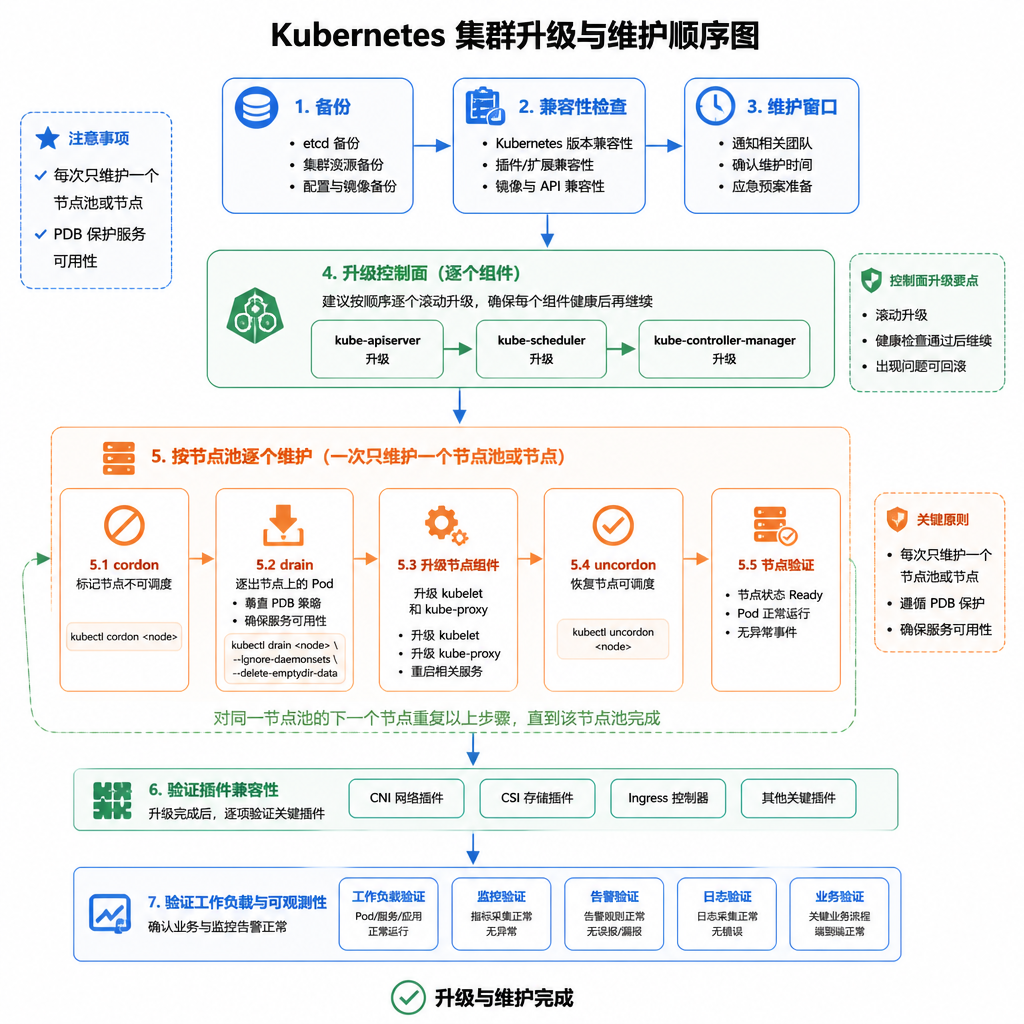
1. 节点维护:cordon、drain、uncordon
# 停止向节点调度新的普通 Pod
kubectl cordon <node-name>

# 驱逐可迁移工作负载;执行前先确认 PDB、裸 Pod 和本地数据影响
kubectl drain <node-name> \
  --ignore-daemonsets \
  --delete-emptydir-data

# 维护完成、节点健康后恢复调度
kubectl uncordon <node-name>
三个操作的区别:
| 操作 | 效果 | 对已有 Pod 的影响 |
|---|---|---|
cordon | 标记节点不可调度 | 已有 Pod 继续运行,不迁移 |
drain | 先 cordon,再逐个驱逐 Pod | 所有可驱逐的 Pod 被迁移到其他节点 |
uncordon | 恢复可调度 | 无影响 |
1.1 drain 的细节
drain 会发起自愿驱逐(Eviction API),受 PDB 约束:
--ignore-daemonsets:DaemonSet Pod 默认不会被驱逐(它们是要"每节点一个"的),不加此参数 drain 会失败;--delete-emptydir-data:使用emptyDir的 Pod 的数据会被删除,不了解应用行为时不能盲目加;- PDB 阻塞:如果驱逐会违反 PDB(如单副本
minAvailable: 1),drain 会一直等待——先扩容或调整 PDB; - 裸 Pod(不属于任何控制器)不会被自动重建,drain 后它们就消失了——确保裸 Pod 只在调试场景使用。
1.2 维护前检查清单
- 确认节点上的工作负载、关键服务副本、PDB 与存储挂载:
kubectl get pods -A --field-selector spec.nodeName=<node-name>kubectl get poddisruptionbudget -Akubectl top nodes
- 确认其他节点有足够的资源承接请求,避免大量 Pod Pending;
- 确认有业务告警、发布冻结或维护窗口,必要时先扩容;
- 对单副本有状态服务制定单独迁移和恢复步骤;
- 记录开始时间、目标节点、预期影响和回滚条件。
2. etcd 备份与恢复
etcd 是 Kubernetes 的"真相源"——所有资源对象(Pod、Service、ConfigMap 等)都存储在 etcd 中。etcd 损坏 = 集群失忆。
2.1 备份 etcd
# 在控制面节点上执行(需要 etcdctl 和证书路径)
ETCDCTL_API=3 etcdctl snapshot save /backup/etcd-snapshot-$(date +%Y%m%d-%H%M).db \
  --endpoints=https://127.0.0.1:2379 \
  --cacert=/etc/kubernetes/pki/etcd/ca.crt \
  --cert=/etc/kubernetes/pki/etcd/server.crt \
  --key=/etc/kubernetes/pki/etcd/server.key

# 验证快照完整性
ETCDCTL_API=3 etcdctl snapshot status /backup/etcd-snapshot-*.db
2.2 恢复 etcd(灾难场景)
# 1. 从快照恢复到临时目录
ETCDCTL_API=3 etcdctl snapshot restore /backup/etcd-snapshot-20260731-0200.db \
  --data-dir=/var/lib/etcd-restore \
  --name=<control-plane-node-name> \
  --initial-cluster=<control-plane-node-name>=https://<ip>:2380 \
  --initial-advertise-peer-urls=https://<ip>:2380

# 2. 修改 etcd 的 data-dir 指向恢复目录,重启 etcd
# 3. 重启 kube-apiserver
托管 Kubernetes(EKS、GKE、AKS)的 etcd 由云厂商管理,你无法直接访问。此时关注的是:集群是否支持快照回滚(如 GKE 的集群回滚)、以及你的资源清单是否在 Git 中有备份(可通过 GitOps 重建资源)。
2.3 不止备份 etcd
单独备份 etcd 或导出 YAML 不能保证完整业务恢复。备份对象应至少包括:
| 备份对象 | 工具/方式 | 恢复优先级 |
|---|---|---|
| etcd 快照 | etcdctl snapshot save | 最高——恢复集群元数据 |
| Kubernetes 资源清单 | Git(GitOps 仓库) | 高——声明式重建资源 |
| 持久化卷数据 | PVC 快照、Velero、云盘快照 | 高——恢复业务数据 |
| 外部数据库 | 数据库原生备份(pg_dump、mysqldump 等) | 高——业务核心数据 |
| Secret/证书 | 密钥管理系统备份 | 中——避免重新签发 |
| 集群插件配置 | Git + 云厂商 CLI | 中——恢复网络和监控 |
3. 版本升级原则
3.1 升级前检测废弃 API
Kubernetes 按版本逐步移除旧 API(如 extensions/v1beta1 在 1.16 移除、policy/v1beta1 在 1.25 移除)。升级前必须检测现有资源是否使用了即将移除的 API:
# 用 kubent(Kube No Trouble)扫描集群
kubent

# 或用 pluto 检测 Helm Release 和集群资源
pluto detect-helm -n <namespace>
pluto detect-api-resources
# 手动查看某个资源的 API 版本
kubectl api-resources | grep -E 'Ingress|PodDisruptionBudget|CronJob'
升级控制面前,确保所有资源已迁移到新 API 版本,否则升级后旧版本 API 不可用,对应资源将无法操作。
3.2 升级顺序
控制面(api-server, scheduler, controller-manager)
  → 节点池(kubelet, kube-proxy, container runtime)
  → CNI 插件(Calico/Cilium/Flannel)
  → CSI 驱动
  → 附加组件(Ingress Controller、metrics-server、监控)
  → 准入控制器和策略
每个阶段之间应有验证窗口。不要一天之内完成所有升级。
3.3 升级纪律
- 先阅读托管服务或发行版的目标版本支持矩阵、弃用 API 和升级顺序;
- 先升级测试集群,验证核心应用、网络、存储、监控、GitOps 和准入策略;
- 控制面、节点池、CNI/CSI、Ingress Controller、监控组件各自有版本兼容性——升级一个时确认其他组件对新版本的兼容声明;
- 跨多个大版本升级时,逐版本升级(如 1.26 → 1.27 → 1.28 → 1.29),不要跳版本;
- 批量节点升级设置并发上限(如一次 20%),实时观察 Pending、重启和错误率;
- 每个阶段都准备停止条件和回滚/恢复方案。
4. 证书管理
# 查看证书到期时间(kubeadm 集群)
kubeadm certs check-expiration

# 续期所有证书
kubeadm certs renew all

# 续期后重启控制面组件使新证书生效
# kubeadm 通常会自动重启相关静态 Pod
证书到期会导致控制面组件间 TLS 通信失败,表现可能是 kubectl 命令超时、API Server 不可用。提前 30 天告警是有必要的。
5. 托管集群与自建集群的责任边界
| 责任 | 托管(EKS/GKE/AKS) | 自建(kubeadm/kops) |
|---|---|---|
| 控制面高可用 | 云厂商 | 你 |
| etcd 备份与恢复 | 云厂商(通常不开放直接访问) | 你 |
| Kubernetes 版本升级 | 控制面:云厂商;节点:你 | 全部你负责 |
| 节点维护与安全补丁 | 你 | 你 |
| CNI/CSI/Ingress Controller | 你 | 你 |
| 工作负载与 RBAC | 你 | 你 |
| 备份与恢复演练 | 你 | 你 |
托管 Kubernetes 帮你省掉的是控制面和 etcd 的运维,但应用的可用性、数据备份和故障恢复仍然是你团队的责任。
6. 练习
练习 A
- 在 kind 集群中
kubectl cordon一个节点,尝试创建新 Deployment,观察新 Pod 是否 Pending kubectl uncordon恢复,确认新 Pod 被调度- 跑一次
kubectl drain --ignore-daemonsets --dry-run=client <node>,看输出中会驱逐哪些 Pod
练习 B(如有 kubeadm 集群访问权限)
- 跑
kubeadm certs check-expiration检查证书到期时间 - 跑
kubent或pluto扫描集群废弃 API
验收清单
- 能解释 cordon、drain、uncordon 的差异
- 知道 drain 受 PDB、emptyDir 和 DaemonSet 影响
- 知道 etcd 备份的两条命令(snapshot save + snapshot status)
- 了解备份不止 etcd:资源清单、PV 数据、外部数据库、Secret 各需独立备份
- 升级前会验证 API 弃用(kubent/pluto)、组件兼容性和测试环境结果
- 知道升级顺序:控制面 → 节点池 → CNI → CSI → 附加组件
- 清楚托管集群与自己建集群的责任边界
- 有可演练的资源与数据恢复方案
最后一篇:kubectl 命令速查。